Просмотр новости
Найдите то, что Вас интересует
 Спутники
 РН
 SpaceX
 Роскосмос
 NASA
СпутникиРНSpaceXРоскосмосNASAВ этом выпуске разбираются несколько актуальных случаев применения нейросетей в научных целях. Вместо простого перечисления того, что читатель и так найдет поисковиком, мы решили поставить вопрос: где обученная нейросеть встроена в работу так, что без нее выполнить задачу невозможно, и где «ИИ» — просто вывеска, под которой находится обычная статистическая модель?
 Илья Белых
В этом выпуске разбираются несколько актуальных случаев применения нейросетей в научных целях. Вместо простого перечисления того, что читатель и так найдет поисковиком, мы решили поставить вопрос: где обученная нейросеть встроена в работу так, что без нее выполнить задачу невозможно, и где «ИИ» — просто вывеска, под которой находится обычная статистическая модель?
Примеры применения ИИ, о которых пойдет речь, можно разделить на несколько групп. Во-первых, приборы и большие установки: это нанопоровый секвенатор, обсерватория имени Веры Рубин и Большой адронный коллайдер, на которых события и оповещения фильтруют с помощью машинного обучения. Применяется этот подход и в работе с сейсмическими каталогами, в наблюдении радиовсплесков, в обнаружении гравитационных волн, в детекторах нейтрино, в изучении плазмы токамака. Вторая группа — инструменты, вросшие в повседневную работу и использующиеся для моделирования структуры белков (AlphaFold), расчета межатомных потенциалов, прогноза погоды, чтения маммограмм, криоэлектронной микроскопии. Наконец, третий случай — новое и спорное. Сгенерированные геномы фагов, расшифрованные свитки Геркуланума, спроектированные белки, успехи в олимпиадной математике, новые материалы и лекарства, статьи, написанные с помощью ИИ, неожиданное поведение агентов при испытаниях. Подробно рассказать о сути всех этих методов в рамках одной статьи невозможно, но если хочется разобраться — смотрите список литературы (он в веб-версии).
Случаи сгруппированы по ответу на вопрос, что случится, если изъять модель из рабочего процесса.
Под словом «модель» будем подразумевать обученный на данных алгоритм: нейросеть, случайный лес, градиентный бустинг. Что это такое и где граница с байесовской оптимизацией, сказано в «Шпаргалке». В пересказах всё это регулярно зовут «искусственным интеллектом», и на этой подмене держится половина недоразумений, поэтому дальше мы каждый раз называем метод.
Обученная модель — алгоритм, параметры которого подобраны по данным, а не выведены из теории.
Сверточная сеть — архитектура для данных с локальной структурой: изображений, сигналов.
Графовая нейросеть — работает с объектами и связями между ними: например, межатомные расстояния, частицы в струе.
Случайный лес — ансамбль решающих деревьев (экспертных алгоритмов, обученных на разных массивах данных). Это обучаемый метод, но не нейросеть. В пересказах его тоже зовут «ИИ».
Байесовская оптимизация — способ искать максимум «дорогой» функции за малое число проб. Подстраивается по собственным пробам в ходе поиска, а не по внешнему обучающему корпусу.
Экспертная система — программа, основанная на составленных вручную правилах. К обучаемым методам не относится.
Расчет функционала плотности — стандартный квантовый способ считать силы между атомами. Эталон, на котором учат потенциалы.
Межатомный потенциал — функция, дающая энергию и силы взаимодействия по положениям атомов.
Нанопоровый секвенатор — прибор для расшифровки генетического кода, который пропускает молекулы ДНК/РНК через микроскопические поры и измеряет изменения электрического тока.
Доклиника — стадия до испытаний на людях. Фазы 1, 2, 3 — испытания на людях, от безопасности к эффективности.
Воспроизводимость — возможность независимо повторить работу. Для сервисных моделей ограничена: отключили версию — точный повтор невозможен.
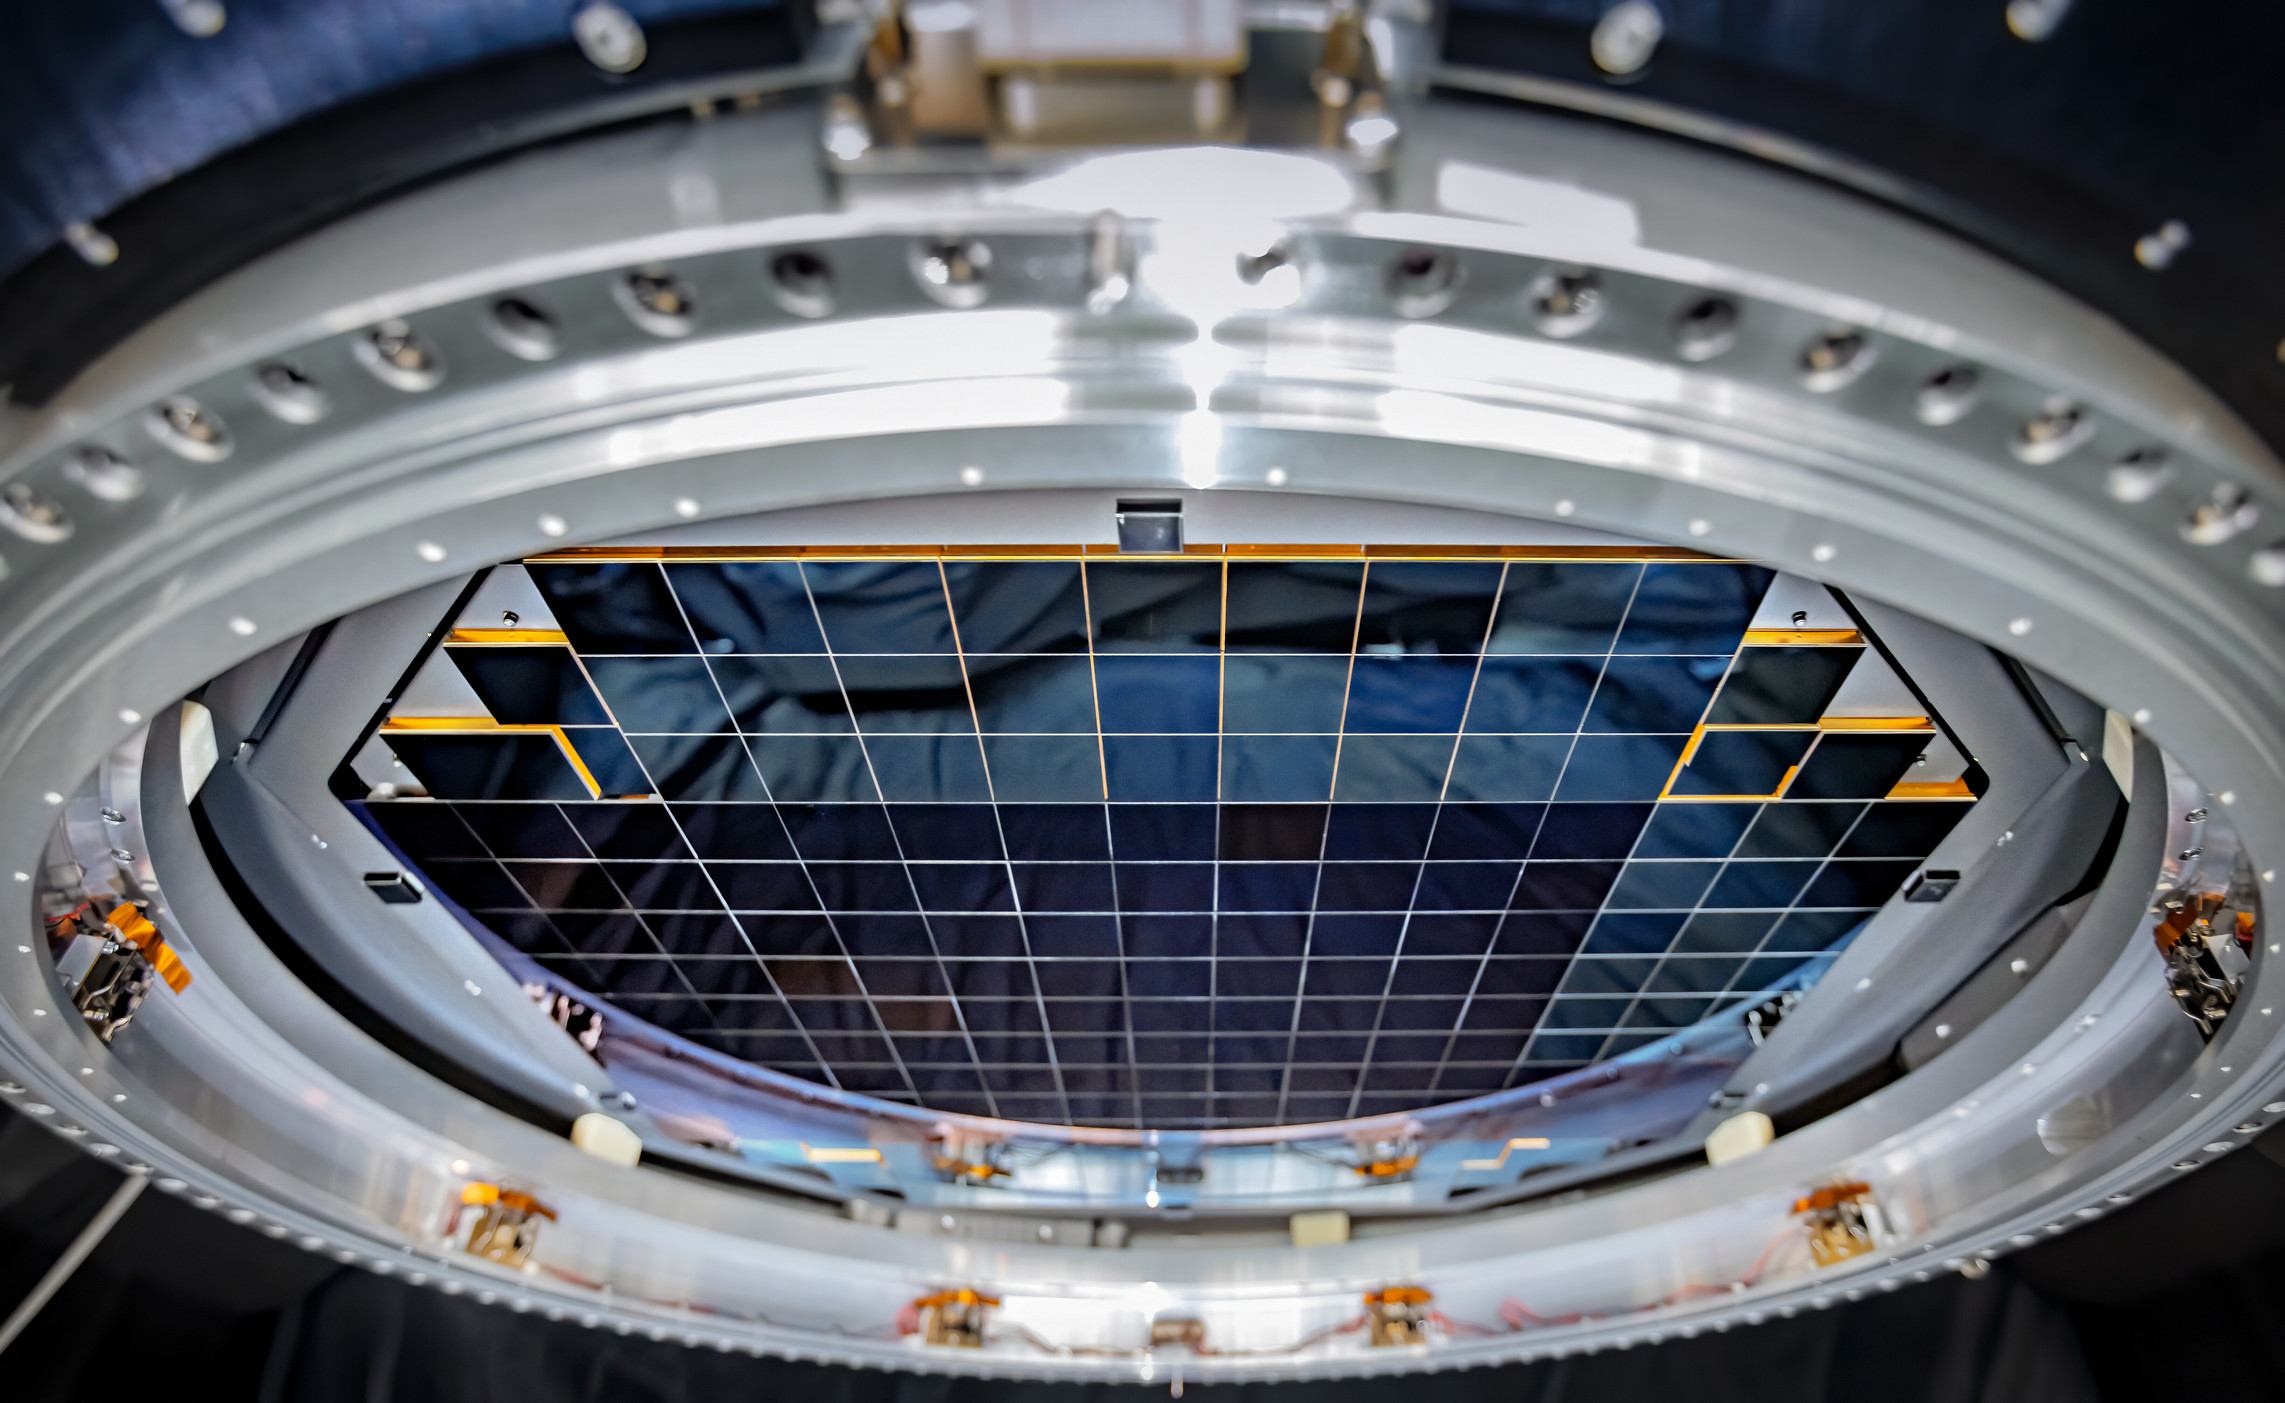 Рис. 1a. Фокальная плоскость камеры LSST, 189 сенсоров на 3200 Мп: этот приемник обсерватории имени Веры Рубин снимает небо, и из сравнения его снимков рождаются ночные оповещения об изменениях [72]. Фото: Jacqueline Orrell/SLAC/NSF/DOE/Rubin Observatory/AURA
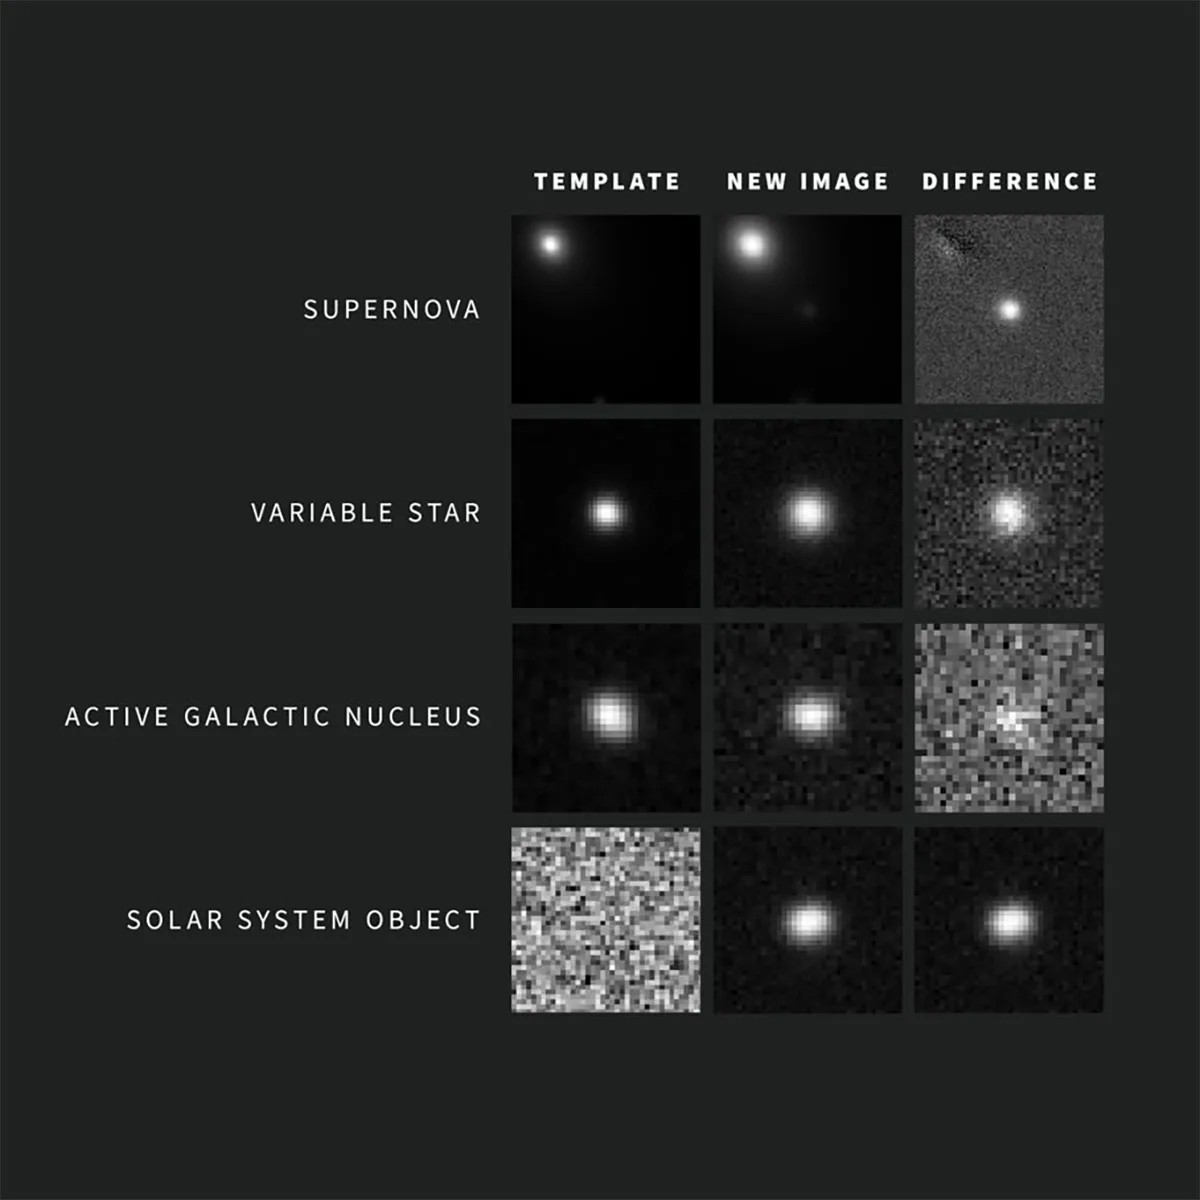 Рис. 1b. Классификация алертов обсерватории имени Веры Рубин: сверхновая, переменная звезда, активное ядро галактики. Источник: NSF–DOE Vera C. Rubin Observatory/NOIRLab/SLAC/AURA
Коротко о результатах. Из разобранных примеров не может работать без ИИ только один прибор: современный нанопоровый секвенатор. Без вычислительного декодера он выдает электрический ток, который слишком зашумлен, чтобы его интерпретировать как буквы генетического кода. Близко к нему стоит чтение обугленных свитков из Геркуланума, но там томограф выдает продукт, с которым можно работать, — карту плотности, и без сетей теряется не сигнал, а его прочтение. Там, где результатом является научное утверждение, последнее слово осталось за человеком. В разобранных здесь случаях анализируется только решение конкретных задач, а не весь путь от вопроса до результата.
Выключи — и работа встанетНанопоровый секвенатор протягивает цепь ДНК через белковую пору и выдает на выходе колебания ионного тока, а не буквы нуклеотидов. Перевод одного в другое, basecalling, с 2017 года делает нейросеть [1]. Отказ от вычислительных декодеров делает прибор неработоспособным. Незаменима здесь не именно нейросеть — до нее ток читали скрытыми марковскими моделями. Медианная точность распознавания нуклеотидов нейросетевого декодера в лучшем из рассмотренных режимов составляет 99,93% [2].
Близки по степени важности нейросетей и обзорные телескопы. Они рассылают за ночь столько оповещений об изменениях неба, что на все человек реагировать не в состоянии. Так, обсерватория имени Веры Рубин за первую ночь своей работы, 24 февраля 2026 года, разослала 800 тыс. публичных оповещений [3]. Это была только пусконаладка, а в рабочем режиме она рассылает до семи миллионов за ночь [57]. Разбирают поток автоматические «брокеры», основанные на разных методах: в системе ALeRCE фрагменты снимков, содержащие возможные события, классифицирует сверточная сеть, а кривые блеска — сбалансированный случайный лес, к нейросетям отношения не имеющий [4]. Без «брокера» телескоп не ослепнет, и данные будут копиться, но прекратится отбор целей в реальном времени, пока событие не погасло. Стало быть, не будет вовремя принято решение о том, куда навести дефицитные большие телескопы.
Столь же критично применение ИИ и в работе с данными Большого адронного коллайдера. Пучки частиц там сталкиваются 40 млн раз в секунду, и записать всё невозможно, данные хранятся только в усеченном виде. Поэтому событие, не отобранное онлайн, полностью восстановить нельзя. С 2022 года часть пороговых алгоритмов на программных шагах отбора в CMS заменена обучаемыми: тау-лептоны сначала размечал классификатор DeepTau, а с 2025 года его в триггере сменили модели на основе графовой сети ParticleNet [5]. Автоэнкодеры (системы фильтрации данных) AXOL1TL и CICADA развернуты прямо в железе еще в 2024 году, и за тот год они отобрали на хранение более 4 млрд событий [6]. Заменить обучаемый отбор пороговым можно: он станет хуже, но не прекратится.
В основе составления сейсмического каталога — списка землетрясений со временем и координатами — лежит еще один рутинный процесс: на записи каждой станции надо отметить момент прихода волны, «вступление». Десятилетиями это делал человек, и его производительность определяла, сколько событий попадет в каталог. Сеть PhaseNet расставляет вступления по каждому отсчету записи [7]. Масштаб виден по каталогу зоны субдукции (места, где одна литосферная плита погружается под другую) в Атакаме: 6,7 млн «вступлений», сопоставленных с событиями, дали более 166 тыс. событий [9]. Дальше применяются классические методы сейсмологии, однако нейросети проникли и в другие задачи. Так, в работе по Центральным Апеннинам ИИ определяет еще и полярности первых вступлений, т. е. входные данные отбирает и обрабатывает нейросеть, а сами движения подземных пород рассчитывает классический алгоритм [8]. В подобных задачах актуальны и классические методы: так, каталог Южной Калифорнии на 1,81 млн землетрясений, который в 2019 году увеличил число известных событий региона на порядок, получен вообще без нейросетей — сопоставлением с шаблонами [10]. Такие примеры иногда ошибочно приписывают ИИ. (Уточним: землетрясения PhaseNet не предсказывает, авторы метода этого и не заявляли…)
Остальные случаи с большими потоками данных укладываются в один абзац. При детектировании гравитационных волн для отбора сигналов и определения параметров источников используются в основном классические алгоритмы. Однако в одном из пяти конвейеров обработки данных каталога GWTC-4.0 вердикт обученного ИИ-классификатора был задействован непосредственно при отборе кандидатов [58]. При наблюдении быстрых радиовсплесков (FRB) на канадском телескопе CHIME события «ловит» классическая дедисперсия (восстановление сигнала после «размытия») с порогами, а обучаемый ИИ занимается чисткой помех. Хотя есть примеры использования нейросетей при классификации кандидатов для ряда телескопов и в этом направлении [73]. Рекордное нейтрино KM3NeT реконструировано методом максимального правдоподобия, и его энергия — около 220 ПэВ при 90-процентном интервале от 72 ПэВ до 2,6 ЭэВ [59]. Управление плазмой обучением с подкреплением показано на токамаке TCV в Лозанне [74], но рутинного штатного режима добиться не удалось. Ни в одном из этих случаев обучаемый компонент не стал основой для детектирования или реконструирования сигнала, итоговый результат везде дает классический метод.
Чтобы понять, ИИ ли это, достаточно задать три вопроса.
Какой именно метод? Под вывеской «искусственный интеллект» могут находиться нейросети разных архитектур, случайные леса, байесовская оптимизация, экспертные системы и обычная статистика. От ответа зависит всё остальное.
Кто проверял, кроме авторов? Рецензирование проверяет рассуждение, а не результат. Независимое воспроизведение — другая процедура, и часто ее нет.
Как далеко дошло? Расчет, пробирка, животные, люди — четыре стадии, и успех на первой не обещает последней. Доклинику нужно называть доклиникой.
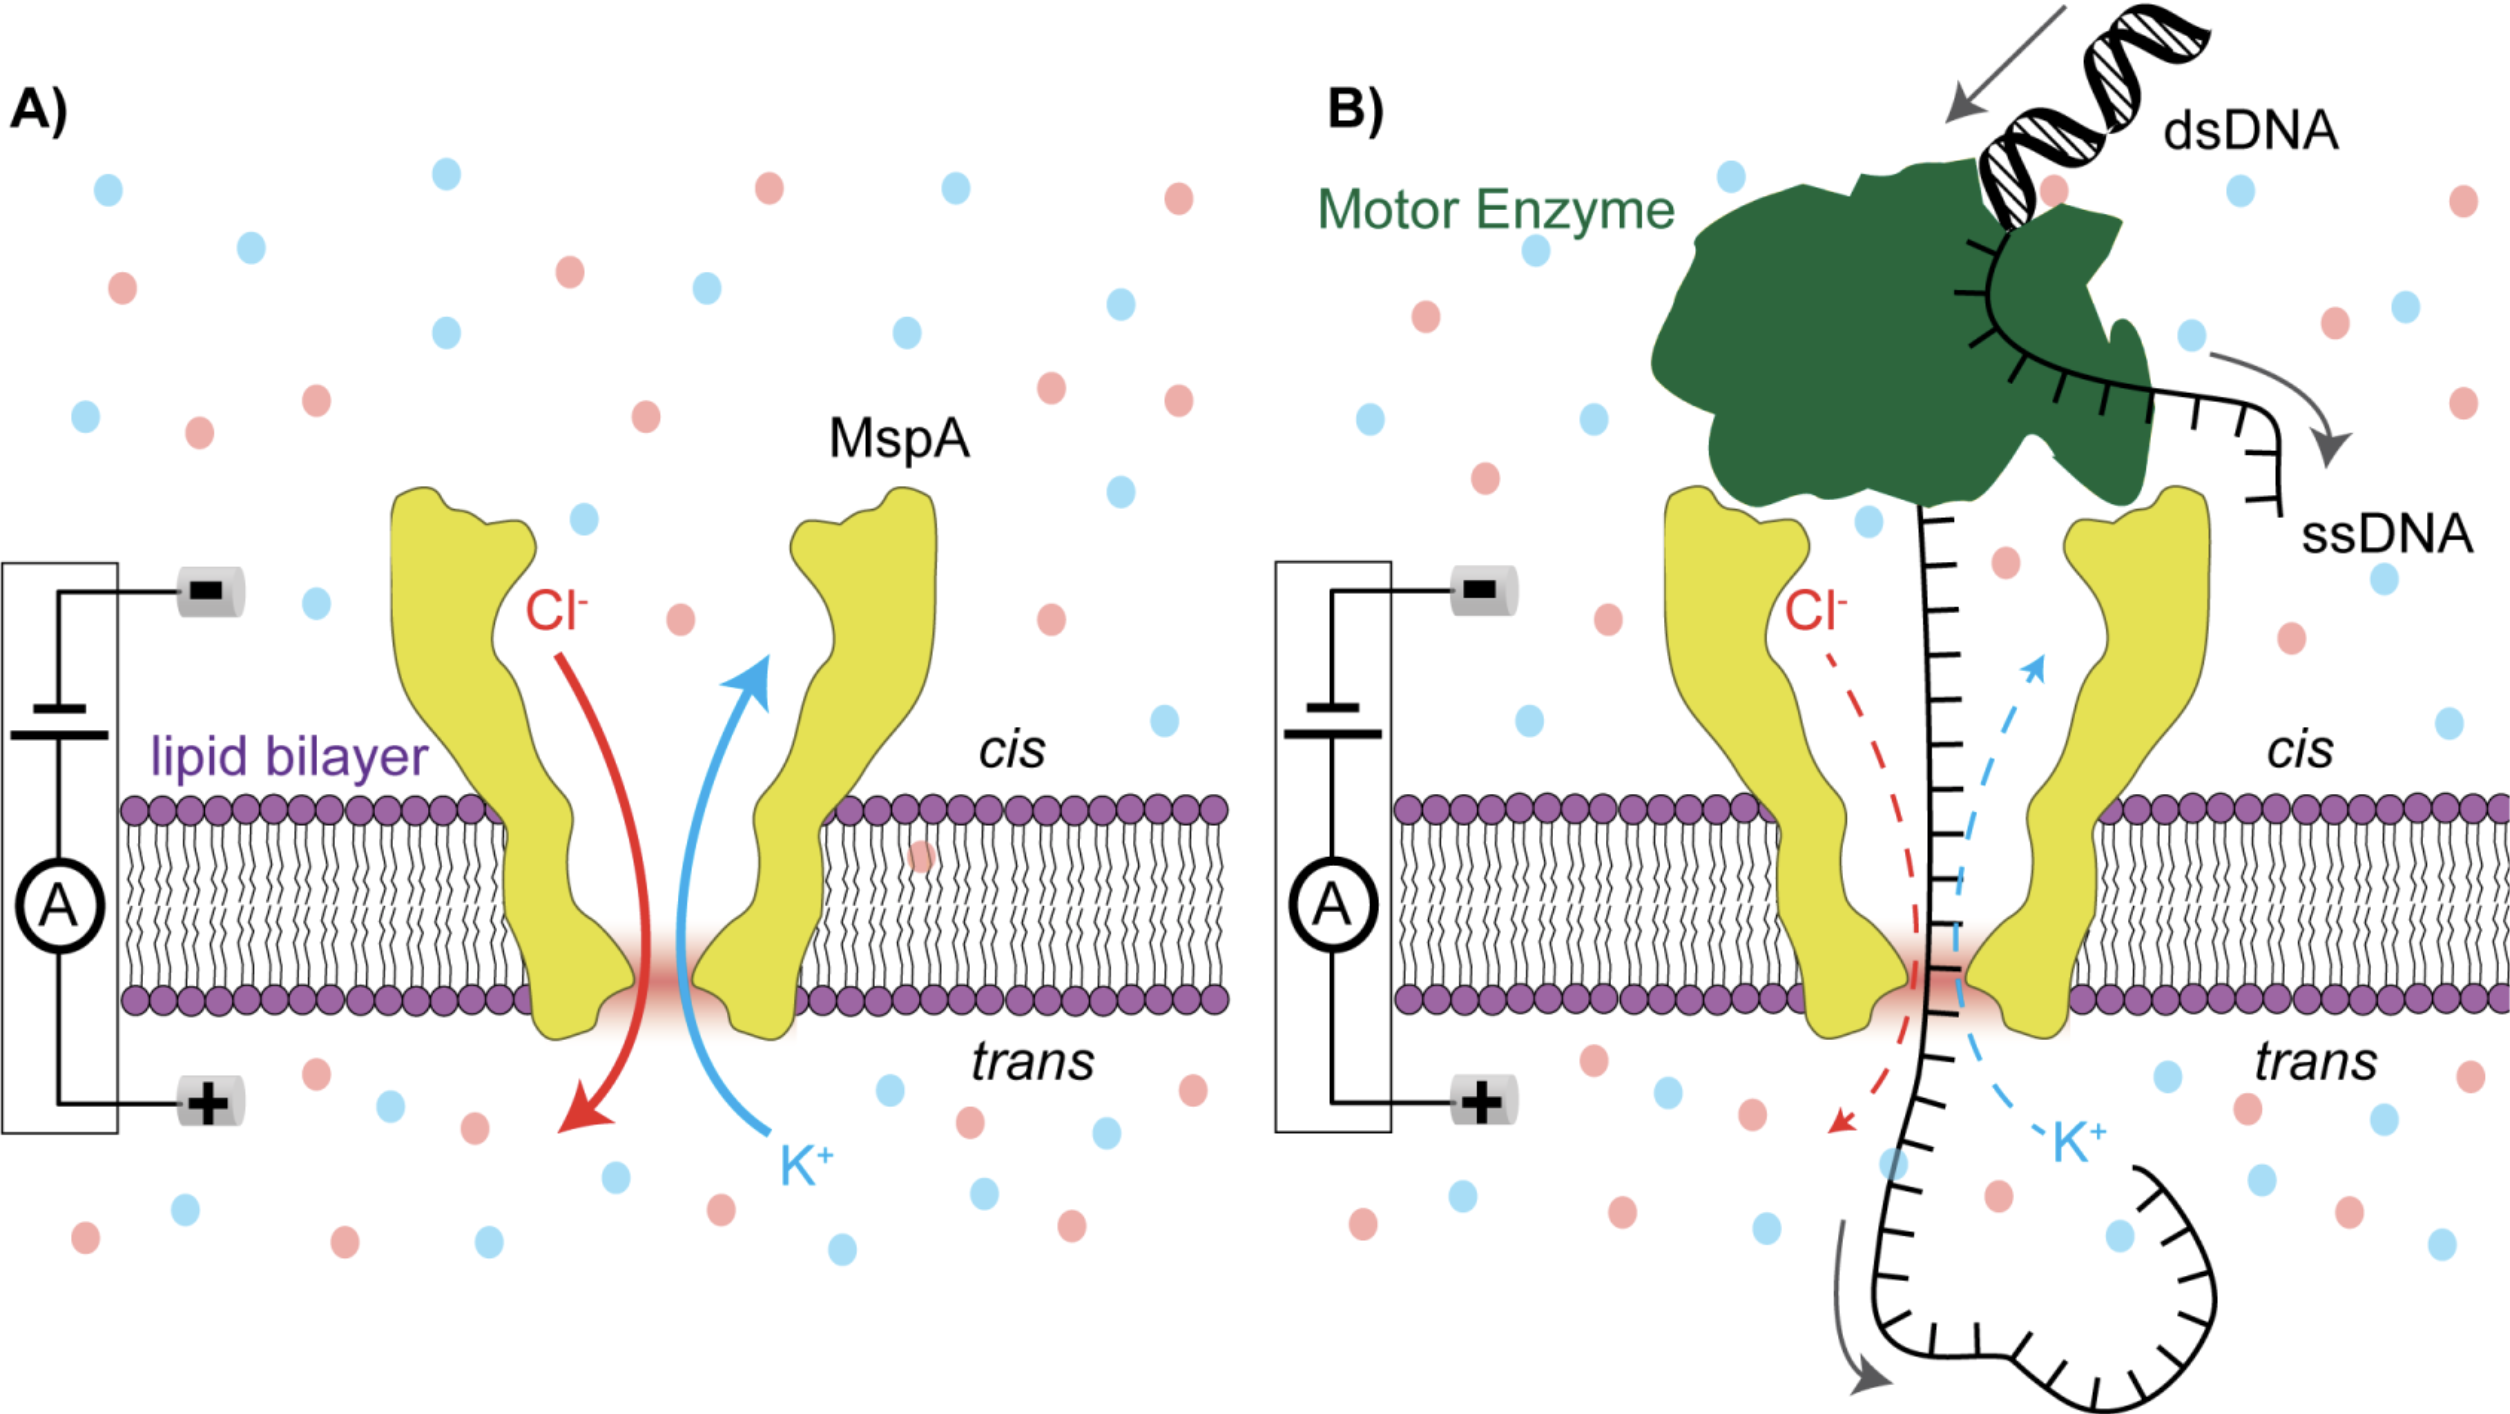 Рис. 2. Устройство нанопорового секвенирования: моторный фермент протягивает цепь ДНК через белковую пору в мембране, и прибор регистрирует изменения ионного тока через эту пору, а не буквы. На схеме — пора MspA, на которой метод отрабатывали в лаборатории. Источник: Nova IC et al., PLoS ONE12(7): e0181599Что будет, если убрать алгоритм
Вторая группа случаев устроена иначе. Здесь работу можно делать по-старому, и она не остановится, но изменится другое — цена, скорость и механизм принятия решения на выходе.
Самый яркий пример — AlphaFold2, метод предсказания пространственной структуры белка по последовательности. Над этой задачей структурная биология билась полвека. AlphaFold2 не решил ее в привычном смысле слова, но превратил отдельное дорогое вычисление в обращение к справочнику: создана база предсказанных структур, более 214 млн записей на 2023 год, которая стала неотъемлемой частью мировых ресурсов по биоинформатике — UniProt, InterPro, Ensembl, PDB (банк белковых структур) [16]. Незаменимость здесь особого рода: выключение модели не уничтожит уже посчитанную базу, но остановится ее обновление. По-прежнему важны и экспериментальные методы: кристаллография, ЯМР и электронная микроскопия как и раньше определяют структуру там, где предсказание ненадежно [16].
Родственный инструмент AlphaMissense оценивает патогенность аминокислотных замен [17], и клиническая рабочая группа, независимая от разработчиков, перекалибровала его строже, чем предлагали авторы [18].
Следующая задача из этой группы — моделирование движения атомов, для которого нужно знать действующие между атомами силы. Стандартный способ это сделать — квантовый расчет функционала плотности: он приближенный, но достаточно точный, чтобы служить эталоном при обучении, и очень дорогой. ИИ-обучение заменяет расчет потенциала предсказанием, при этом точность остается близкой, а стоимость (на графических ускорителях) — почти как для традиционных расчетов по упрощенным формулам (классическим потенциалам) [12]. Это интерполяция по уже посчитанному, и работает она только внутри обученной области, а за ее пределами может выдавать физически бессмысленные результаты. Что дает такая замена, видно по рекорду — посчитана молекулярная динамика для системы из 113 млн атомов меди [13] — это задача, которая с квантовым расчетом сил не решается вовсе [61].
Численный прогноз погоды появился раньше, чем сами компьютеры. Первую попытку сделал Льюис Фрай Ричардсон в годы Первой мировой, служа водителем в квакерском санитарном отряде на Западном фронте. Расчеты он делал вручную, на арифмометрах, в паузах между поездками за ранеными. На шестичасовой ретроспективный прогноз у него ушло почти шесть недель, при этом, согласно его расчетам, давление должно было вырасти на 145 гектопаскалей (109 мм рт. ст., изменение катастрофического масштаба), тогда как барометр почти не шелохнулся. В книге 1922 года Ричардсон описал «фабрику прогнозов»: зал с картой мира на стенах, в нём — 64 тыс. людей-вычислителей, призванных «обгонять» погоду [70]. Сегодня прогноз погоды — область, где обученная модель работает в оперативном режиме и ее продукт ежедневно доходит до миллионов людей. Европейский центр среднесрочных прогнозов ввел модель AIFS в оперативную работу в 2025 году, вторая версия работает с мая 2026 года, 15-суточный прогноз она считает за минуты и тратит примерно в тысячу раз меньше энергии, чем предыдущая [22]. AIFS не заменила классическую модель: та работает параллельно и, что важнее, дает данные для обучения и задания начальных условий ИИ-модели. Выключите классическую систему — остановится и AIFS, но не наоборот. Гибрид NeuralGCM показывает то же еще нагляднее: под вывеской «ИИ предсказывает климат» там физическое ядро, у которого обучаемый блок заменяет подсеточную часть [24].
Следующая область, где ИИ и классические методы идут рука об руку, — криоэлектронная микроскопия. Сеть Topaz находит частицы на зашумленных снимках, ModelAngelo строит атомную модель по карте плотности [19, 20], а в световой микроскопии Cellpose сегментирует клетки [21]. Байесовская рамка трехмерной реконструкции устояла, но с 2024 года в сам цикл уточнения встроен обучаемый регуляризатор, нейросеть-шумоподавитель [60], — т. е. модель отвечает уже не только за подготовительные этапы. Незаменимой ее и здесь назвать нельзя: картинка с нейросетевым шумоподавлением выглядит правдоподобно, но это не гарантирует ее соответствия реальности — нужен отбор по шаблонам и ручная правка.
С использованием ИИ в медицине тоже пока двойственная картина. Так, в Швеции было проведено рандомизированное испытание результатов маммографии. 105 934 женщины на плановом скрининге случайно распределили между обычным двойным чтением снимков и исследованием с ИИ [26]. Промежуточный анализ на 80 033 участницах вышел в 2023 году и показал снижение нагрузки на чтение снимков на 44% [25]. Результаты опубликованы в январе 2026 года: было обнаружено 1,55 случая интервального рака (опухоли, найденной между обследованиями; если их меньше, то скрининг работает лучше) на тысячу против 1,76 в контрольной группе, инвазивных интервальных раков оказалось на 16% меньше [26]. Надо заметить, что сравнение производилось с двойным чтением (снимки анализируют два врача), принятым в Швеции, статистика при чтении в одиночку была бы иной.
По мировому масштабу применения ИИ в клинической практике систематических данных нет, но кое-что можно оценить. Так, по американской статистике на конец 2025 года существовало около полутора тысяч разрешений на медицинские устройства с машинным обучением, из них примерно три четверти — в радиологии [55].
Что общего у этих примеров? Там, где результат становится научным утверждением, последнее слово по-прежнему за людьми. Но это слово — не на входе, а на выходе. Человек не успевает за возросшим объемом информации, которую дают приборы. Узкое место науки переехало: раньше это было получение данных, теперь — проверка.
Частая подмена в этой теме — показатель промежуточного шага выдают за научный или клинический выигрыш.
Хорошая классификация оповещений означает не больше открытий, а лучший список целей для телескопов.
Высокое место в сводной таблице предсказания материалов не означает, что ИИ сконструировал нечто пригодное для синтеза и тем более полезное.
Снижение нагрузки на чтение снимков на 44% означает не то, что рака стали находить больше, — для этого есть отдельный показатель, и он измерялся отдельно.
Число разрешенных устройств означает число разрешений, а не их клиническую пользу.
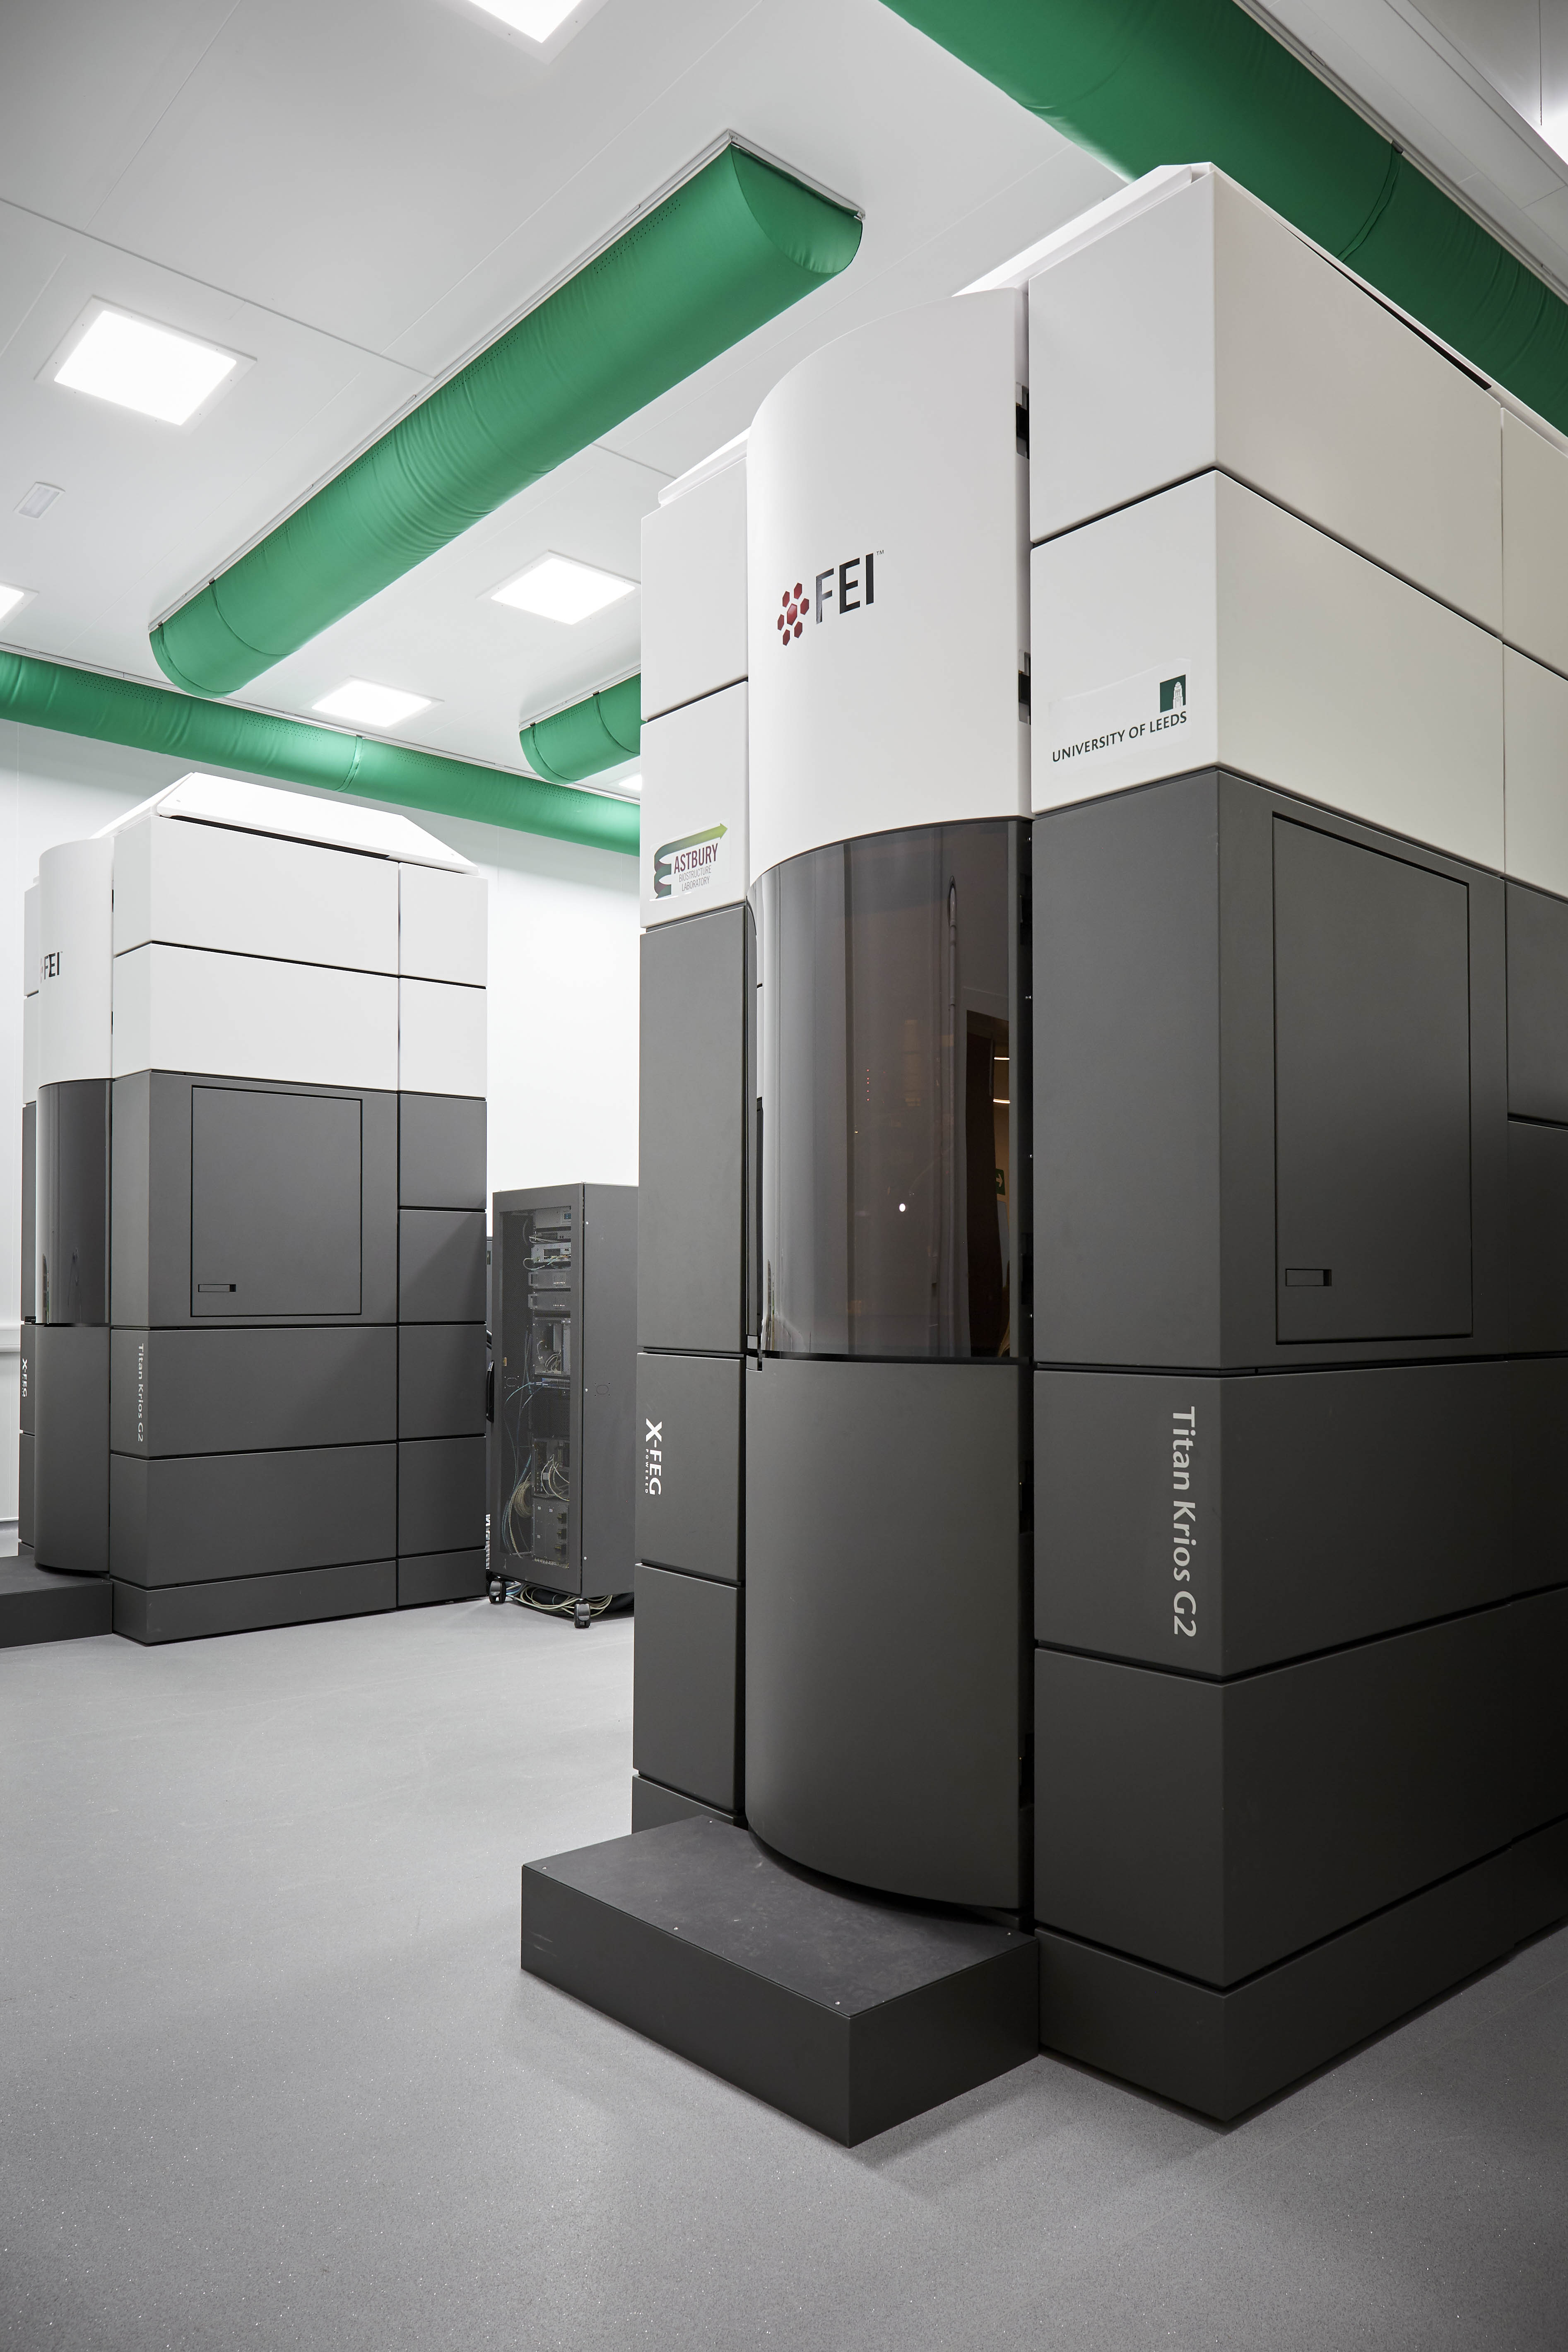 Рис. 3. Криоэлектронные микроскопы Titan Krios в Лидсском университете: приборы этого класса дают те зашумленные снимки, на которых частицы теперь находит нейросеть. Фото: Hiramano92 / «Википедия»
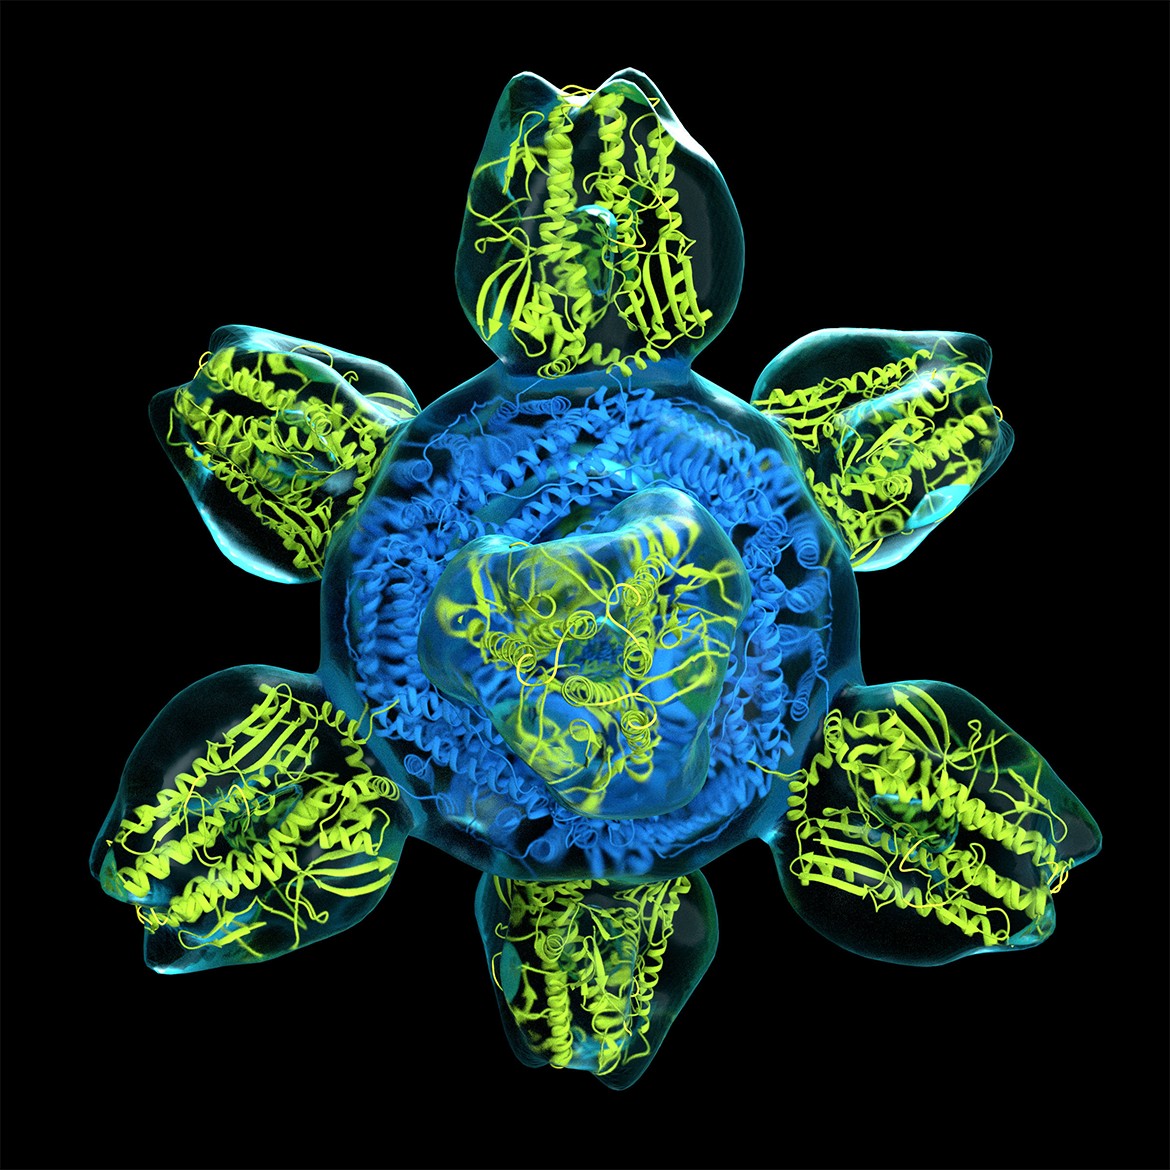 Рис. 4. Белковая наночастица-кандидат на универсальную вакцину против гриппа. Восемь молекул гемагглютинина (желтые) расположены на поверхности белкового каркаса (синий). Структура определена методом криоэлектронной микроскопии. Изображение: NIAID (США)
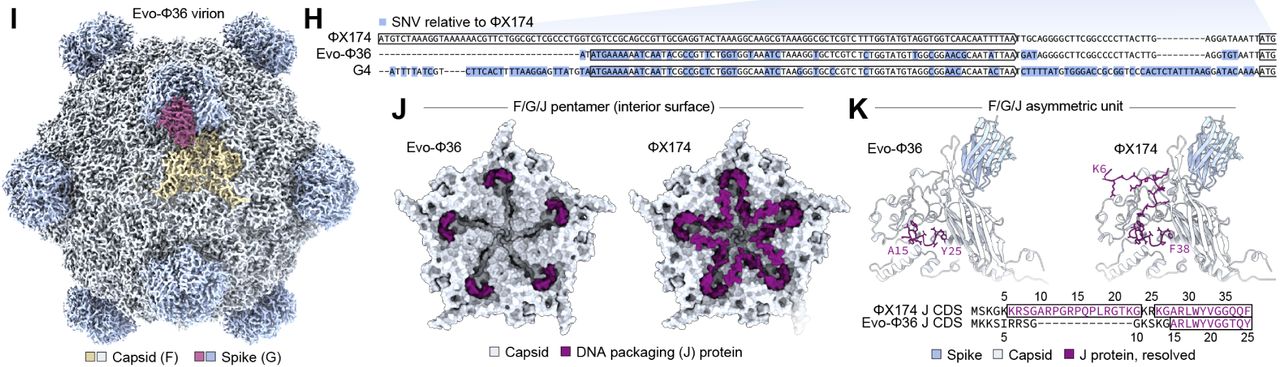 Рис. 5. Так выглядит результат работы геномной языковой модели. Крио-ЭМ‑структура искусственно созданного бактериофага Evo-Φ36 (на парах картинок — слева) в сравнении с исходным фагом ΦX174 (справа). Источник: doi.org/10.1101/2025.09.12.675911Новое и спорное
Здесь модель предъявляет то, чего без нее не было бы под рукой: сконструированную структуру, проявленный текст, синтезированную молекулу. Проверка везде остается человеческой.
6 августа 2026 года в Science вышла работа, где геномные языковые модели Evo 1 и Evo 2 сгенерировали геномы бактериофагов, родственных вирусу ΦХ174 [30]. Из сгенерированного отобрали 302 варианта, собрали 285, жизнеспособными оказались 16. Заголовки говорили о том, что искусственный интеллект создал новую жизнь. Однако большинство отобранных кандидатов совпадают более чем на 40% с исходным вирусом и с геномами обучающей выборки, а с ближайшими природными родственниками того же семейства — на 93,0–98,8%. Речь о конструировании близкородственных объектов по шаблону, и авторы прямо об этом говорят. Работа рецензирована, однако «мокрую проверку» (лабораторные испытания) вел тот же консорциум, а независимого воспроизведения в работе нет.
В июне 2026 года был опубликован результат по полной виртуальной расшифровке одного из сохранившихся свитков Геркуланума [31]. Эти свитки — часть крупной библиотеки, пострадавшей при извержении Везувия в 79 году и обнаруженной в 1750 году при рытье колодца. Первые свитки команда Карла Вебера извлекла в октябре 1752-го. Развернуть их вручную было невозможно, поскольку они сильно обуглились. В 1753 году ватиканский хранитель рукописей Антонио Пьяджо решил создать машину, которая раскрывала свиток шелковыми нитями на грузах и винтах. Чтобы развернуть первый из свитков, ушло четыре года, а некоторые артефакты рассыпались, так и оставшись непрочитанными [71]. Нужно было найти метод, который позволит узнать, что на свитке, не повреждая его физически. Цепочка такая: синхротронная микротомография дает трехмерную карту плотности, нейросети выделяют поверхность папируса и «проявляют» чернила, а транскрибируют и интерпретируют текст восемь папирологов. Прочитанный текст предъявляет не модель, она делает его видимым. Журнального рецензирования публикации пока нет.
Выше шла речь о прогнозировании структуры белков, а вот диффузионная модель RFdiffusion конструирует белковые остовы с нуля. Можно сказать, что она «рисует» новый, не существовавший в природе белок подобно тому, как нейросети типа MidJourney генерируют картинки. Доля «удачных связывателей» (белков, выполняющих поставленные задачи — например, прикрепиться к нужному вирусу), по замерам самих авторов, — около 19% [32]. Родственный случай — сгенерированный моделью ESM3 флуоресцентный белок esmGFP, который только на 58% соответствует ближайшему флуоресцентному белку, известному в природе [33]. Флуоресцентность подтвердили авторы статьи; независимой проверки пока нет. Громкая фраза в Nature про «500 млн лет эволюции», которые удалось «перескочить» с помощью ИИ, требует поправки: никакой симуляции времени в модели нет, другое дело, что примерно столько времени нужно природе, чтобы белковые структуры разных организмов настолько разошлись. Модель же прошла это расстояние за один акт генерации.
В математике твердо установленного немного. Связка AlphaProof и AlphaGeometry решила четыре задачи из шести на Международной математической олимпиаде 2024 года, что отвечает уровню серебряной медали, и это рецензировано [34]. Сама AlphaProof справилась с тремя негеометрическими задачами из этих четырех. Дальше начинается спорное: летом 2025 года о золоте объявили несколько компаний, и процедуры проверки у них несопоставимы. Олимпиада заявила официально, что не может подтвердить ни методы, ни объем использованных вычислений, ни участие человека, ни воспроизводимость результата [64]. Слова ее президента о том, что одна из компаний набрала 35 баллов из 42, опубликованы в блоге самой этой компании, а не в официальных источниках олимпиады [69]. У другой компании решения проверяли нанятые ею медалисты, технического отчета нет, выложены только сами решения [75].
Материалы и лекарства — сюжет, где показательный пример известен, а продолжения нет. В 2023 году две работы в Nature сообщили о миллионах предсказанных неорганических кристаллических структур (различных оксидов и фосфатов) и автономной лаборатории, синтезировавшей 41 из 58 предсказанных соединений [37]. Дальше химики опубликовали предметную критику [38], а в январе 2026 года вышла авторская корректура: слово «новые» в заголовке заменено на «неорганические», один состав из 41 исключен из зачета новых, потому что уже был в обучающей выборке, а из оставшихся 40 подтверждены 36, еще четыре остались неопределенными по данным дифракции [39]. Итоговой доли успеха корректура не называет. Еще скромнее результаты генеративной модели MatterGen: из огромного массива сгенерированных ИИ вариантов выбрали как пригодные для синтеза четыре, а получить удалось только один, и тот — с множественными дефектами кристаллической структуры [40].
С лекарствами надо сразу отказаться от иллюзий: девять из десяти препаратов, дошедших до клинических испытаний, на рынок так и не вышли [41]. Дальше всего на этом пути продвинулся препарат рентосертиб, предназначенный для борьбы с идиопатическим легочным фиброзом: компания-разработчик провела испытание второй фазы на 71 пациенте с обнадеживающими результатами [42], третья фаза на 320 пациентов стартовала в июле 2026 года, новостей еще нет [62].
Наконец тексты. Если в предсказании структуры кристаллов и синтезе лекарства ИИ еще делает первые шаги, в генерации текста ИИ явно преуспел. Это касается и научных работ. Так, изучение словарного запаса более 15 млн публикаций с 2010 по 2024 год на ресурсе PubMed показало, что не менее 13,5% текста в аннотациях 2024 года написано ИИ-моделями [44]. Препринт той же лаборатории намерил по полным текстам 52% за тот же год и 89% к декабрю 2025-го [46]. Напрямую эти числа сравнивать не следует: у препринта другой оценщик и другая единица анализа. При этом автоматизация идет и со стороны чтения и анализа материалов. Программа ASReview, использующаяся при отборе литературы для обзоров, начинала на наивном байесовском классификаторе, сейчас по умолчанию работает на методе опорных векторов, а нейросети подключаются к ней расширением [63]. При этом регулирование в этой сфере пока развито слабо: как правило, научные фонды только рекомендуют раскрывать использование ИИ в подготовке заявок. А вот при рецензировании его применение в ряде научных журналов прямо запрещено [68]. Проект агентства ARPA-H, где модели сортируют и реферируют заявки, а люди принимают решение, остается единственным известным мне прецедентом допуска ИИ к оценке научных текстов [49].
И сакраментальный вопрос: а не заменит ли ИИ ученых как таковых? Громкие заявления технологических компаний о создании полноценных «ИИ-ученых» и автономных агентов сегодня активно проверяют на специализированных испытаниях-бенчмарках. Воспроизвести работу с крупной конференции лучший агент смог на 21% по замеру авторов набора [50], аспиранты на подмножестве из трех статей — на 41%, но это разные выборки. На биоинформатических вопросах с вариантами ответа модели, по отчету авторов набора, не поднялись выше случайного угадывания, а в режиме, где разрешен отказ от ответа, показали результаты ниже него [51]. Против 61 эксперта на инженерных задачах агенты вчетверо результативнее на дистанции в два часа, но на 32 часах люди уже вдвое лучше, и замеряли это на моделях конца 2024 года [52]. До нижней медальной ступени в соревнованиях по анализу данных агент не дотягивает в пяти случаях из шести [53]. Набор FrontierScience от OpenAI дал 25% на исследовательских вопросах, и сравнить эту цифру не с чем: человеческого эталона авторы не делали [54].
Что значит «незаменим»Незаменимость бывает трех видов. Природная — где выход прибора становится нечитаемым без декодера. Экономическая — где по-старому можно, но абсурдно дорого. И мнимая: зависимость от чужого сервиса, встроенность базы в инфраструктуру, поток данных от прибора, спроектированного под модель. В третьем случае за незаменимость выдают нежелание отказываться от принятого решения — технического, организационного, коммерческого.
Обученная модель работает сегодня как расширитель: она добавляет объем, который переварит грамотный специалист, и снимает нехватку рук. Судить о том, насколько хороши эти системы, по опубликованным успехам нельзя: они не показывают, как часто попытки проваливаются.
Google Flu Trends оценивала заболеваемость гриппом по поисковым запросам. В сезон 2012–2013 годов она завышала ее более чем наполовину, на пике февраля 2013-го давала вдвое больше визитов к врачу, чем насчитала служба эпиднадзора CDC, а за два года с августа 2011-го завышала оценку в 100 неделях из 108. Разбор в Science назвал среди причин «высокомерие больших данных» (высокомерны, конечно, не данные, а исследователи, которые их получили и считают, что разбираться в их сути необязательно. — Прим. ред.) и изменение логики работы самого поисковика [27].
IBM Watson for Oncology, по обнаруженным в 2018 году внутренним документам, выдавала небезопасные рекомендации по лечению, потому что обучали её на синтетических случаях, а не на реальных данных [56].
Epic Sepsis Model внедрен во многих больницах США. Разработчик заявлял ее показатель точности 0,76–0,83, независимая проверка на 38 тыс. госпитализаций дала 0,63, и две трети случаев сепсиса система пропустила [28].
Модели диагностики ковида по снимкам: систематический обзор 2021 года отобрал 62 работы из 2212 и заключил, что ни одна не пригодна для клиники [29].
Илья Белых
1. Wick R. R., Judd L. M., Holt K. E. Performance of neural network basecalling tools for Oxford Nanopore sequencing // Genome Biology. 2019. Vol. 20. P. 129. doi.org/10.1186/s13059-019-1727-y
2. Hall M. B. et al. Benchmarking reveals superiority of deep learning variant callers on bacterial nanopore sequence data // eLife. 2024. doi.org/10.7554/eLife.98300.3
3. Rubin Observatory Launches Real-Time Discovery Machine for Monitoring the Night Sky. 25.02.2026. rubinobservatory.org/news/first-alerts
4. Förster F. et al. The Automatic Learning for the Rapid Classification of Events (ALeRCE) Alert Broker // Astronomical Journal. 2021. Vol. 161. P. 242. doi.org/10.3847/1538-3881/abe9bc
5. Machine learning in online and offline reconstruction and identification with CMS (обзор, охватывает DeepTau, ParticleNet и замену DeepTau в триггере с 2025 года). arxiv.org/abs/2602.08010
6. CMS Collaboration. Unsupervised anomaly detection for real-time data acquisition in the CMS experiment at the Large Hadron Collider. 10.08.2026. cds.cern.ch/record/3188808
7. Zhu W., Beroza G. C. PhaseNet: a deep-neural-network-based seismic arrival-time picking method // Geophysical Journal International. 2019. Vol. 216. P. 261-273.
doi.org/10.1093/gji/ggy423
8. Meier M.-A., Lanza F., Martínez-Garzón P., Chiaraluce L. Insights into Extensional Tectonics from a Large Deep Learning Focal Mechanism Catalog // Bulletin of the Seismological Society of America. 2025. Vol. 115(6). P. 2690. doi.org/10.1785/0120250103
9. Münchmeyer J. et al. Characterizing the Atacama Segment of the Chile Subduction Margin with >165,000 Earthquakes // JGR Solid Earth. 2025. doi.org/10.1029/2025JB031256
10. Ross Z. E., Trugman D. T., Hauksson E., Shearer P. M. Searching for hidden earthquakes in Southern California // Science. 2019. Vol. 364. P. 767-771. doi.org/10.1126/science.aaw6888
12. Leimeroth N., Erhard L. C., Albe K., Rohrer J. Machine-learning interatomic potentials from a user’s perspective: a comparison of accuracy, speed and data efficiency // Modelling and Simulation in Materials Science and Engineering. 2025. Vol. 33(6). 065012. doi.org/10.1088/1361-651X/adf56d
13. Lu D. et al. 86 PFLOPS Deep Potential Molecular Dynamics simulation of 100 million atoms with ab initio accuracy // Computer Physics Communications. 2021. Vol. 259. P. 107624. doi.org/10.1016/j.cpc.2020.107624
16. Varadi M. et al. AlphaFold Protein Structure Database in 2024 // Nucleic Acids Research. 2024. Vol. 52(D1). P. D368-D375. doi.org/10.1093/nar/gkad1011
17. Cheng J. et al. Accurate proteome-wide missense variant effect prediction with AlphaMissense // Science. 2023. Vol. 381. eadg7492. doi.org/10.1126/science.adg7492
18. Bergquist T. et al. Calibration of additional computational tools expands ClinGen recommendation options for variant classification with PP3/BP4 criteria // Genetics in Medicine. 2025. Vol. 27(6). 101402. doi.org/10.1016/j.gim.2025.101402
19. Bepler T. et al. Positive-unlabeled convolutional neural networks for particle picking in cryo-electron micrographs // Nature Methods. 2019. Vol. 16. P. 1153-1160.
doi.org/10.1038/s41592-019-0575-8
20. Jamali K. et al. Automated model building and protein identification in cryo-EM maps // Nature. 2024. Vol. 628. doi.org/10.1038/s41586-024-07215-4
21. Stringer C. et al. Cellpose: a generalist algorithm for cellular segmentation // Nature Methods. 2021. Vol. 18. P. 100-106. doi.org/10.1038/s41592-020-01018-x
22. Moldovan G. et al. AIFS Single 1.1.0: an update to ECMWF’s machine-learned weather forecast model AIFS // Geoscientific Model Development. 2026. Vol. 19. P. 4703-4724. doi.org/10.5194/gmd-19-4703-2026
24. Kochkov D. et al. Neural general circulation models for weather and climate // Nature. 2024. Vol. 632. P. 1060. doi.org/10.1038/s41586-024-07744-y
25. Lång K. et al. Artificial intelligence-supported screen reading versus standard double reading in the Mammography Screening with Artificial Intelligence trial (MASAI) // The Lancet Oncology. 2023. doi.org/10.1016/S1470-2045(23)00298-X
26. Lång K. et al. // The Lancet. 2026. Vol. 407(10527). P. 505-514. doi.org/10.1016/S0140-6736(25)02464-X
27. Lazer D., Kennedy R., King G., Vespignani A. The Parable of Google Flu: Traps in Big Data Analysis // Science. 2014. Vol. 343. P. 1203-1205. doi.org/10.1126/science.1248506
28. Wong A. et al. External Validation of a Widely Implemented Proprietary Sepsis Prediction Model in Hospitalized Patients // JAMA Internal Medicine. 2021. Vol. 181(8). P. 1065. doi.org/10.1001/jamainternmed.2021.2626
29. Roberts M. et al. Common pitfalls and recommendations for using machine learning to detect and prognosticate for COVID-19 using chest radiographs and CT scans // Nature Machine Intelligence. 2021. Vol. 3. P. 199. doi.org/10.1038/s42256-021-00307-0
30. King S. H. et al. Generative design of bacteriophages with genome language models // Science. 2026. Vol. 393. eaec2657. doi.org/10.1126/science.aec2657
31. Angelotti G. et al. Complete virtual unwrapping and reading of a rolled Herculaneum papyrus. arxiv.org/abs/2606.29085
32. Watson J. L. et al. De novo design of protein structure and function with RFdiffusion // Nature. 2023. Vol. 620. P. 1089-1100. doi.org/10.1038/s41586-023-06415-8
33. Hayes T. et al. Simulating 500 million years of evolution with a language model // Science. 2025. doi.org/10.1126/science.ads0018
34. Hubert T., Mehta R., Sartran L. et al. Olympiad-level formal mathematical reasoning with reinforcement learning // Nature. 2026. Vol. 651. P. 607-613 (онлайн 12.11.2025). doi.org/10.1038/s41586-025-09833-y
37. Merchant A. et al. Scaling deep learning for materials discovery // Nature. 2023. Vol. 624. P. 80-85. doi.org/10.1038/s41586-023-06735-9; Szymanski N. J. et al. An autonomous laboratory for the accelerated synthesis of novel materials // Nature. 2023. Vol. 624. P. 86-91. doi.org/10.1038/s41586-023-06734-w
38. Leeman J. et al. Challenges in High-Throughput Inorganic Materials Prediction and Autonomous Synthesis // PRX Energy. 2024. Vol. 3. 011002. doi.org/10.1103/PRXEnergy.3.011002; Cheetham A. K., Seshadri R. Artificial Intelligence Driving Materials Discovery? // Chemistry of Materials. 2024. Vol. 36. P. 3490. doi.org/10.1021/acs.chemmater.4c00643
39. Author Correction // Nature. 2026. Vol. 650. E1. doi.org/10.1038/s41586-025-09992-y
40. Zeni C. et al. A generative model for inorganic materials design // Nature. 2025. doi.org/10.1038/s41586-025-08628-5
41. Sun D., Gao W., Hu H., Zhou S. Why 90% of clinical drug development fails and how to improve it? // Acta Pharmaceutica Sinica B. 2022. Vol. 12(7). P. 3049-3062.
doi.org/10.1016/j.apsb.2022.02.002
42. Rentosertib in idiopathic pulmonary fibrosis: a phase 2a trial // Nature Medicine. 2025. Vol. 31. P. 2602-2610. doi.org/10.1038/s41591-025-03743-2
44. Kobak D. et al. Delving into LLM-assisted writing in biomedical publications through excess vocabulary // Science Advances. 2025. doi.org/10.1126/sciadv.adt3813
46. Holzwarth L., González-Márquez R., Kobak D. Most biomedical publications show signs of LLM-assisted writing. arxiv.org/abs/2608.10715
49. ARPA-H. IGoR program statement. arpa-h.gov/explore-funding/programs/igor/statement
50. PaperBench: Evaluating AI’s Ability to Replicate AI Research. arxiv.org/abs/2504.01848
51. BixBench: a Comprehensive Benchmark for LLM-based Agents in Computational Biology. arxiv.org/abs/2503.00096
52. RE-Bench: Evaluating frontier AI R&D capabilities of language model agents against human experts. arxiv.org/abs/2411.15114
53. MLE-bench: Evaluating Machine Learning Agents on Machine Learning Engineering. arxiv.org/abs/2410.07095
54. FrontierScience. arxiv.org/abs/2601.21165
55. FDA. Artificial Intelligence and Machine Learning (AI/ML)-Enabled Medical Devices (официальный перечень, обновляется). fda.gov/medical-devices/software-medical-device-samd/artificial-intelligence-and-machine-learning-aiml-enabled-medical-devices; FDA. Premarket Notification 510(k). fda.gov/medical-devices/premarket-submissions-selecting-and-preparing-correct-submission/premarket-notification-510k
56. Ross C., Swetlitz I. IBM’s Watson recommended ‘unsafe and incorrect’ treatments for cancer patients // STAT. 25.07.2018.
statnews.com/2018/07/25/ibm-watson-recommended-unsafe-incorrect-treatments
57. Rubin Observatory. Официальный релиз о начале десятилетнего обзора LSST. 30.06.2026. rubinobservatory.org
58. LIGO Scientific Collaboration, Virgo Collaboration, KAGRA Collaboration (Abac A. G. et al.). GWTC-4.0: Methods for Identifying and Characterizing Gravitational-wave Transients // The Astrophysical Journal Letters. 2026. Vol. 1004. P. L21. doi.org/10.3847/2041-8213/ae447b
59. KM3NeT Collaboration. Observation of an ultra-high-energy cosmic neutrino with KM3NeT // Nature. 2025. Vol. 638. P. 376-382. doi.org/10.1038/s41586-024-08543-1
60. Kimanius D., Jamali K., Wilkinson M. E., Lövestam S., Velazhahan V., Nakane T., Scheres S. H. W. Data-driven regularization lowers the size barrier of cryo-EM structure determination // Nature Methods. 2024. Vol. 21. P. 1216-1221. doi.org/10.1038/s41592-024-02304-8
61. Matbench Discovery — открытая таблица сравнения обучаемых межатомных потенциалов. matbench-discovery.materialsproject.org
62. ClinicalTrials.gov. NCT07687459: испытание третьей фазы рентосертиба, зарегистрировано 07.07.2026.
63. ASReview. Документация: модели и расширения. asreview.readthedocs.io
64. International Mathematical Olympiad. The 66th International Mathematical Olympiad draws to a close today. 19.07.2025. imo2025.au/news/the-66th-international-mathematical-olympiad-draws-to-a-close-today/
68. National Institutes of Health. NOT-OD-23-149: The Use of Generative Artificial Intelligence Technologies is Prohibited for the NIH Peer Review Process. 23.06.2023. grants.nih.gov/grants/guide/notice-files/NOT-OD-23-149.html; National Science Foundation. Notice to the research community: Use of generative artificial intelligence technology in the NSF merit review process. 14.12.2023, обновлено 21.05.2026. nsf.gov/news/notice-to-the-research-community-on-ai; Thorp H. H., Vinson V. Change to policy on the use of generative AI and large language models // Science. 16.11.2023. science.org/content/blog-post/change-policy-use-generative-ai-and-large-language-models
69. Google DeepMind. Advanced version of Gemini with Deep Think officially achieves gold-medal standard at the International Mathematical Olympiad. 21.07.2025.
deepmind.google/blog/advanced-version-of-gemini-with-deep-think-officially-achieves-gold-medal-standard-at-the-international-mathematical-olympiad/
70. Richardson L. F. Weather Prediction by Numerical Process. Cambridge: Cambridge University Press, 1922. P. 219 (archive.org/details/weatherpredictio00richrich); Lynch P. The origins of computer weather prediction and climate modeling // Journal of Computational Physics. 2008. Vol. 227. P. 3431-3444. doi.org/10.1016/j.jcp.2007.02.034
71. Fowler R. L. The Herculaneum Papyri // Manuscript and Text Cultures. 2024. Vol. 3(1). doi.org/10.56004/v3.1rlf; Getty Museum. Buried by Vesuvius: Treasures from the Villa dei Papiri. getty.edu/art/exhibitions/villa_papiri; Royal Society. Volcanic vistas. 2021. royalsociety.org/blog/2021/03/volcanic-vistas
72. Rubin V. C. An Interesting Voyage // Annual Review of Astronomy and Astrophysics. 2011. Vol. 49. P. 1-28. doi.org/10.1146/annurev-astro-081710-102545; Carnegie Science. Vera Rubin: Opening doors to dark matter and women in STEM. carnegiescience.edu/vera-rubin-opening-doors-dark-matter-and-women-stem
73. CHIME/FRB Collaboration. The CHIME Fast Radio Burst Project: System Overview // The Astrophysical Journal. 2018. Vol. 863. P. 48. doi.org/10.3847/1538-4357/aad188; Agarwal D. et al. FETCH: A deep-learning based classifier for fast transient classification // MNRAS. 2020. Vol. 497. P. 1661. doi.org/10.1093/mnras/staa1856
74. Degrave J. et al. Magnetic control of tokamak plasmas through deep reinforcement learning // Nature. 2022. Vol. 602. P. 414-419. doi.org/10.1038/s41586-021-04301-9
75. Wei A. Запись в X от 19.07.2025 о золотом уровне модели OpenAI на IMO 2025 и проверке решений тремя бывшими медалистами. twitter.com/alexwei_/status/1946477742855532918; решения — github.com/aw31/openai-imo-2025-proofs
| # | Наименование новости | Тональность | Информативность | Дата публикации |
|---|---|---|---|---|
| 1 | ИИ в бизнесе: кто несет ответственность за ошибки нейросети | 0 | 9.81 | 18-09-2026 |
| 2 | Искусственный интеллект как угроза научной деятельности | 0 | 6.53 | 10-02-2026 |
| 3 | Вы как-то перестраиваете процессы под новую реальность с ИИ? | 0 | 5 | 04-06-2026 |
| 4 | Нехватка кадров сдерживает внедрение ИИ в научной среде | 0 | 10.39 | 11-08-2026 |
| 5 | ИСИЭЗ НИУ ВШЭ: как вузы и НИИ внедряют ИИ | 0 | 9.03 | 30-07-2026 |
| 6 | 🔥 ИИ в науке и промышленности: как технологии меняют «тяжёлые» ... | 0 | 8.47 | 10-09-2026 |
| 7 | ИИ в законе. Как примирить авторское право и обучение нейросетей | 0 | 6.81 | 11-08-2026 |
| 8 | ИИ в медицине: на пути к клиническому применению | 0 | 10.96 | 03-08-2026 |
| 9 | Искуственный интеллект в образовании: вызовы, задачи, перспективы В 2000-е годы ... | 0 | 8.16 | 11-08-2026 |